| talosctl get machinestatus |
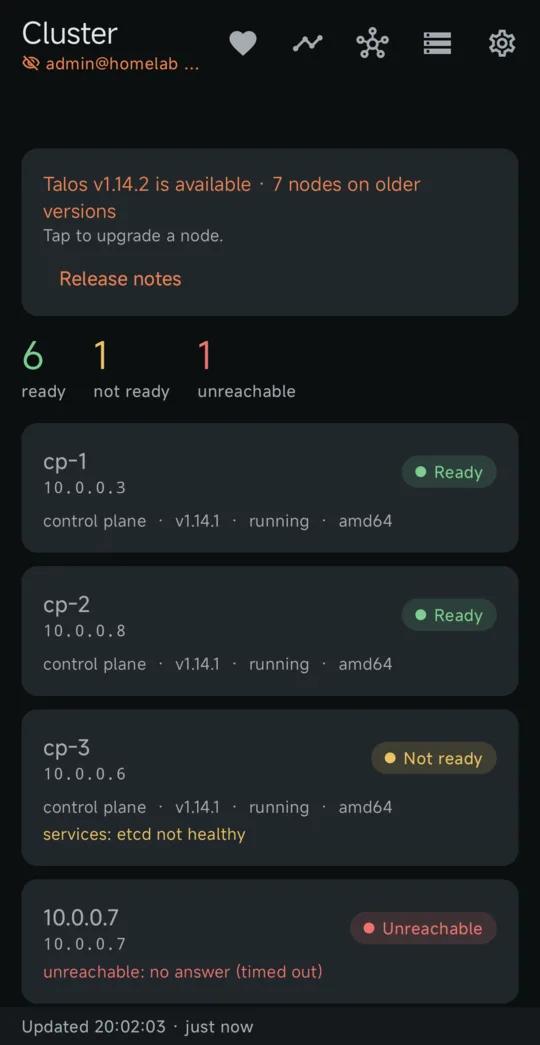
ClusterübersichtJeder Node: bereit, nicht bereit oder nicht erreichbar, mit den unerfüllten Bedingungen, der Uhrzeitabweichung und verfügbaren Talos-Upgrades. |
reader |
| talosctl services, talosctl logs -f |
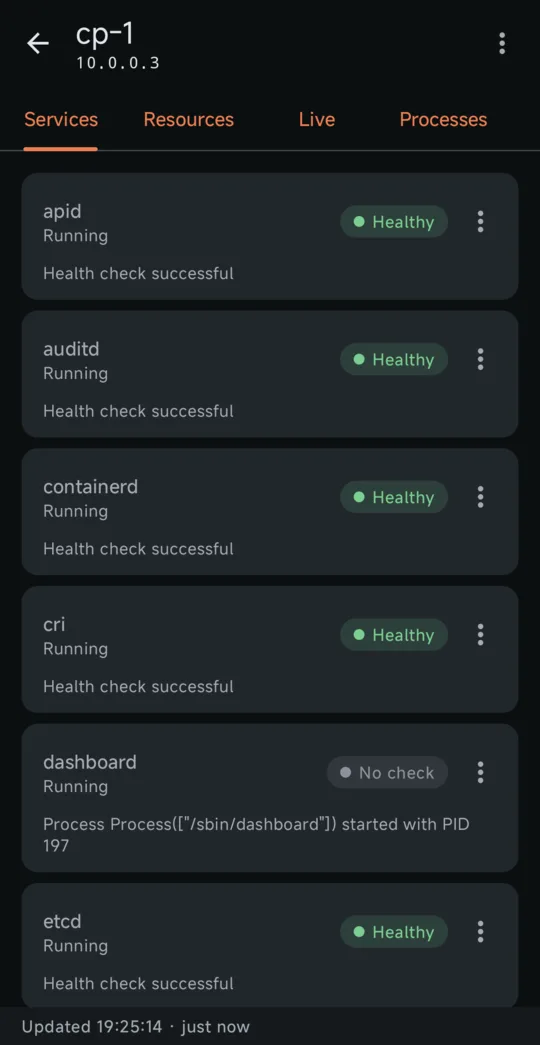
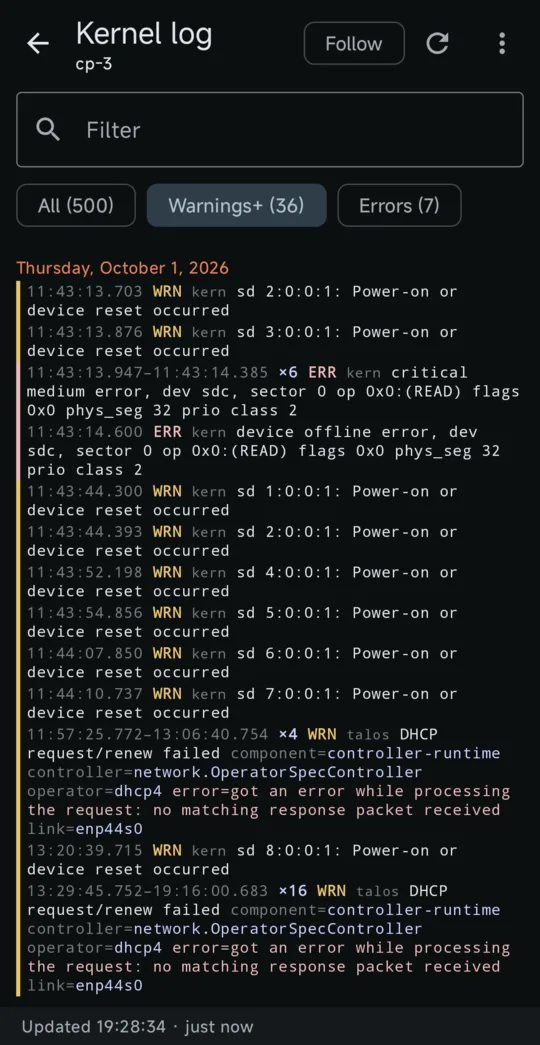
Dienste und LogsDienstzustand sowie Dienst- und Kernel-Logs, nach Level eingefärbt, mit zusammengefassten Wiederholungen und Live-Verfolgung. |
reader |
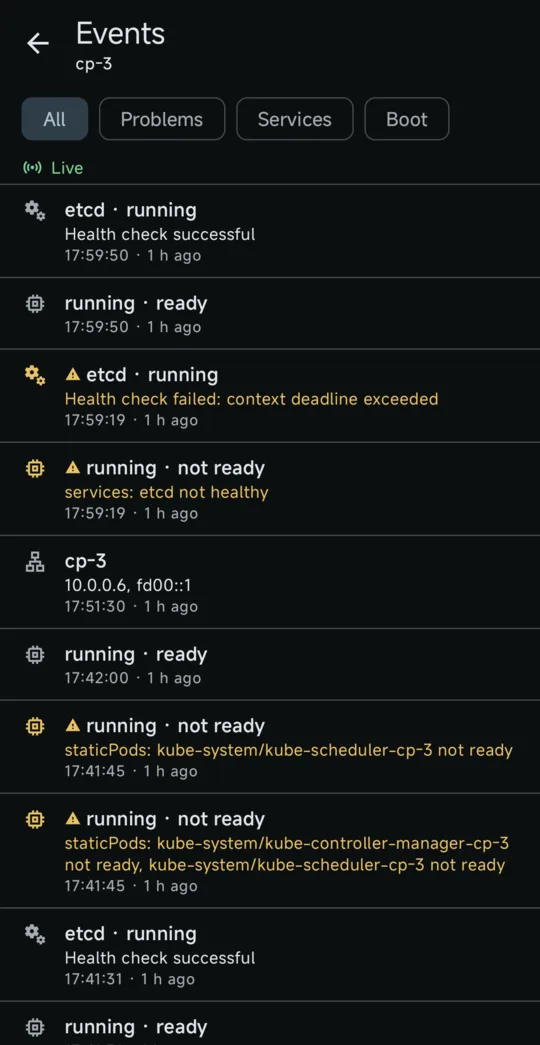
| talosctl events |
Ereignis-ZeitachseDienständerungen, Boot-Phasen und Adressänderungen im ganzen Cluster, in Echtzeit. |
reader |
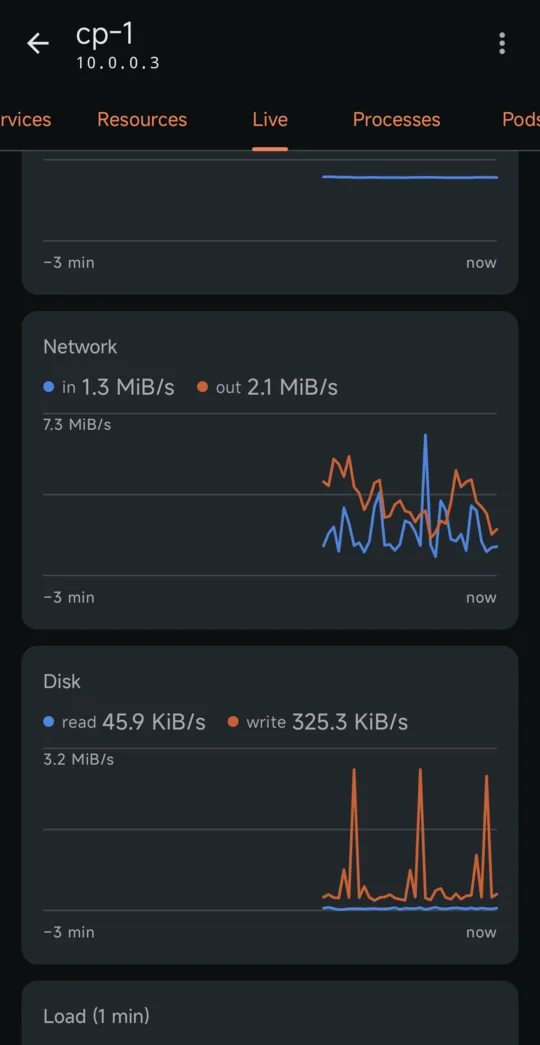
| talosctl dashboard, talosctl processes |
Live-Diagramme und ProzesseCPU, Speicher, Netzwerk, Datenträger und Last alle zwei Sekunden, und die Prozessliste nach CPU oder Speicher sortiert. |
reader |
| talosctl get members |
Node-ErkennungCluster-Mitglieder, die deine talosconfig noch nicht anspricht, mit einem Tipp zum Kontext hinzugefügt, und unter Android eine Suche im lokalen Netzwerk, wenn kein Endpoint antwortet. |
reader |
| diff of talosctl get … on every node |
KonfigurationsabweichungenDNS, NTP, MTUs, Erweiterungen, Secure Boot, UKI und Talos-Versionen, innerhalb einer Rolle oder mit einem gespeicherten Referenzstand verglichen. |
reader |
| talosctl events + watch, in a terminal |
VorfallsaufzeichnungEreignisse und erfasster Node-, Dienst- und Netzwerkzustand, zusammengeführt in einer gespeicherten Zeitachse. |
reader |
| talosctl read /proc/stat, /proc/diskstats |
EngpassmetrikenE/A-Wartezeit, Steal-Zeit, E/A pro Datenträger sowie Fehler und verworfene Pakete pro Schnittstelle, live. |
reader |
| talosctl containers -k |
PodsContainer nach Pod gruppiert, mit CPU und Speicher. |
reader |
| talosctl containers -k on every node |
App-InventarDie im Cluster laufende Software, gruppiert in Apps mit Logos, Versionen, Versionsabweichungen und nicht fixierten Images. |
reader |
| talosctl get links, talosctl netstat |
NetzwerkSchnittstellen, Adressen, Routen, DNS- und Zeitserver sowie offene Verbindungen. |
reader |
| talosctl apply-config --mode try |
MaschinenkonfigurationDie Konfiguration des Nodes Feld für Feld oder als YAML, Secrets verborgen, bis du sie aufdeckst. Bearbeite sie und probiere die Änderung aus: Der Node setzt sich selbst zurück, wenn du sie nicht behältst. |
admin |
| talosctl etcd status, etcd snapshot |
etcdMitglieder, Leader, Größe und Alarme, Defragmentierung und ein Snapshot, auf dem Smartphone gespeichert. |
reader / backup |
| talosctl get kubespanpeerstatuses |
KubeSpanDie Peers jedes Nodes: Status, Endpoint, letzter Handshake und Traffic, und unter Android eine Karte der Standorte, Nodes und Tunnel. |
reader |
| talosctl service restart |
DienststeuerungEinen Dienst starten, stoppen oder neu starten, mit einer Warnung bei kritischen Diensten. |
operator |
| talosctl reboot -m powercycle |
Neustart, Herunterfahren und AufweckenGeordnet, per Power-Cycle oder erzwungen, nachdem du zur Bestätigung den Hostnamen eingetippt hast. Wecke einen ausgeschalteten Node per Wake-on-LAN auf. |
operator |
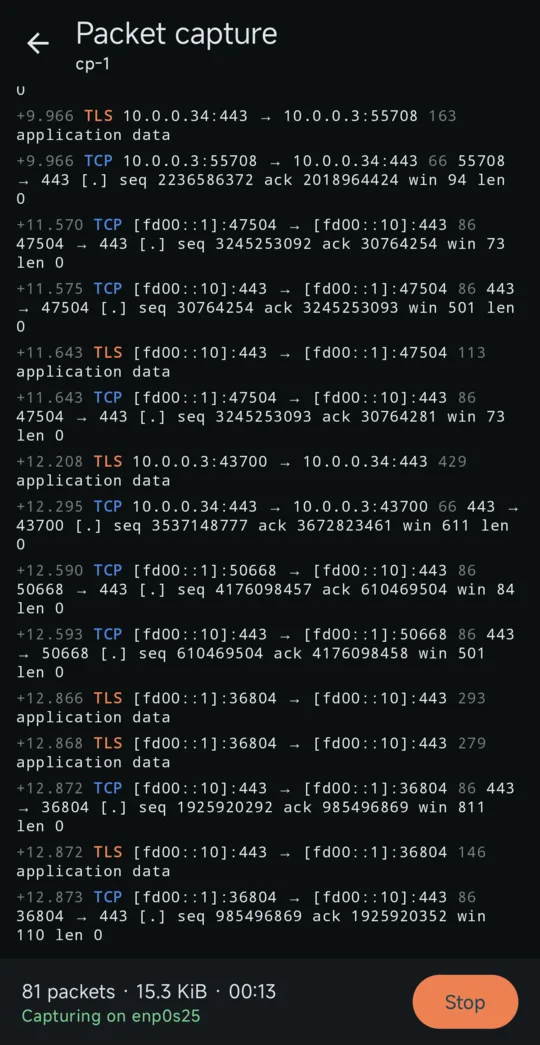
| talosctl pcap |
PaketmitschnittEine Live-Paketliste mit dekodierten Details, gespeichert als .pcap zum Öffnen in Wireshark. |
operator |
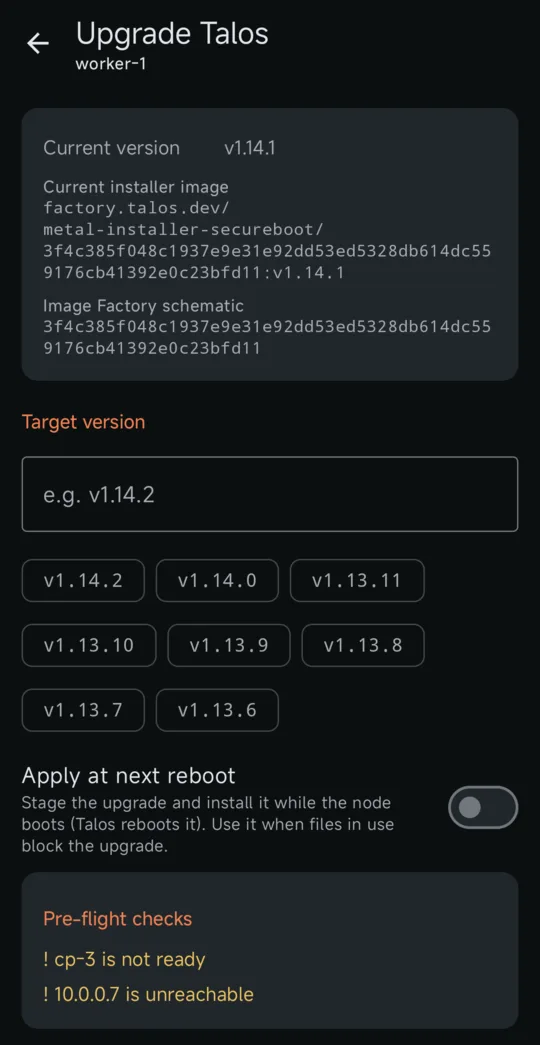
| talosctl upgrade |
Talos-UpgradeEin Node nach dem anderen, abgelehnt, wenn etcd das Quorum verlieren würde, mit Fortschrittsanzeige, bis der Node wieder da ist. |
admin |
| kubectl get deploy,sts,ds, kubectl rollout restart |
Kubernetes-WorkloadsBereitschaft und Rollout-Status jedes Deployments, StatefulSets und DaemonSets, und ein Rolling Restart nach einer Bestätigung. |
admin |
| kubectl get cronjobs, kubectl create job --from |
Kubernetes-CronJobsZeitplan, nächster Lauf und letzte Läufe jedes CronJobs, mit dem Icon und Namen, die du ihm gibst, und ein manueller Lauf nach einer Bestätigung. |
admin |
| kubectl get pods, kubectl delete pod |
Kubernetes-PodsPod-Status, Bereitschaft, Neustarts und Node, problematische zuerst; lösche einen hängenden Pod, damit sein Controller ihn neu erstellt. |
admin |
| cilium connectivity perf, netperf |
NetzwerktestTCP-Durchsatz und Latenz von p50 bis p99 zwischen zwei Nodes, von Pod zu Pod oder Host zu Host, gespeichert und im Zeitverlauf dargestellt. |
admin |
| kubectl get volumes.longhorn.io, clusters.postgresql.cnpg.io |
DatendiensteLonghorn-Volumes, CloudNativePG-Cluster und ihre Backups, Garage und Dragonfly, mit dem Node hinter jedem Problem. |
admin |
| talosctl cgroups |
Node-Druck und CgroupsCPU-, Speicher- und Datenträgerdruck, der Workload, der am meisten wartet, OOM-Kills und die Nutzung pro Dienst, Pod und Container. |
admin |
| talosctl config new |
talosconfig ausstellenDas Zertifikat dieses Smartphones erneuern oder ein nur lesendes für ein anderes Gerät als QR-Code erstellen. |
admin |
| talosctl health |
Cluster-ZustandsprüfungDie serverseitigen Prüfungen, live übertragen, während sie laufen. |
admin |
| talosctl debug |
Debug-ShellStarte ein Image wie nicolaka/netshoot auf einem Node und erhalte ein Terminal, mit rund 40 fertigen Befehlen. |
admin |