| talosctl get machinestatus |
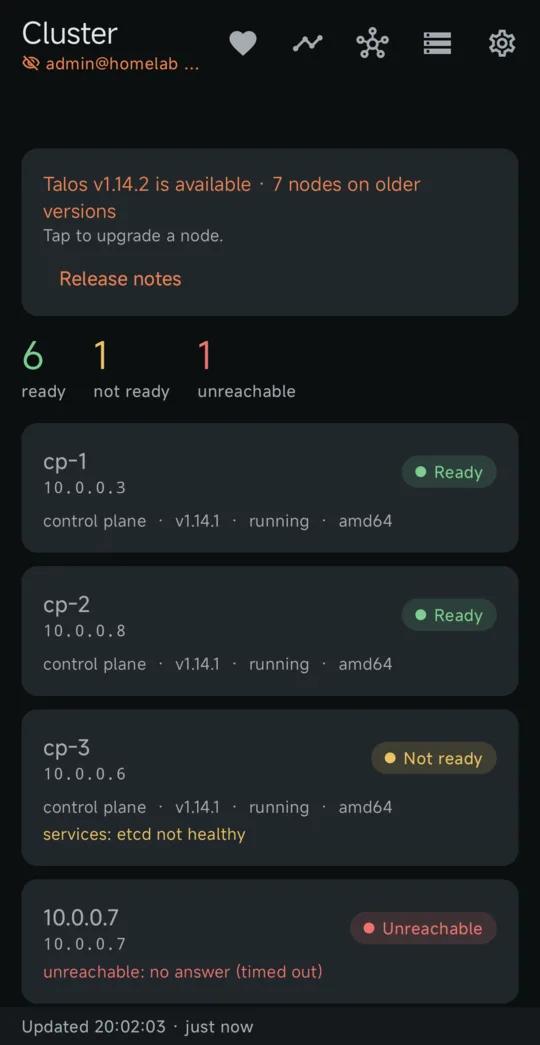
ClusterübersichtJeder Node: bereit, nicht bereit oder nicht erreichbar, mit den unerfüllten Bedingungen, der Uhrzeitabweichung und verfügbaren Talos-Upgrades. |
reader |
| talosctl services, talosctl logs -f |
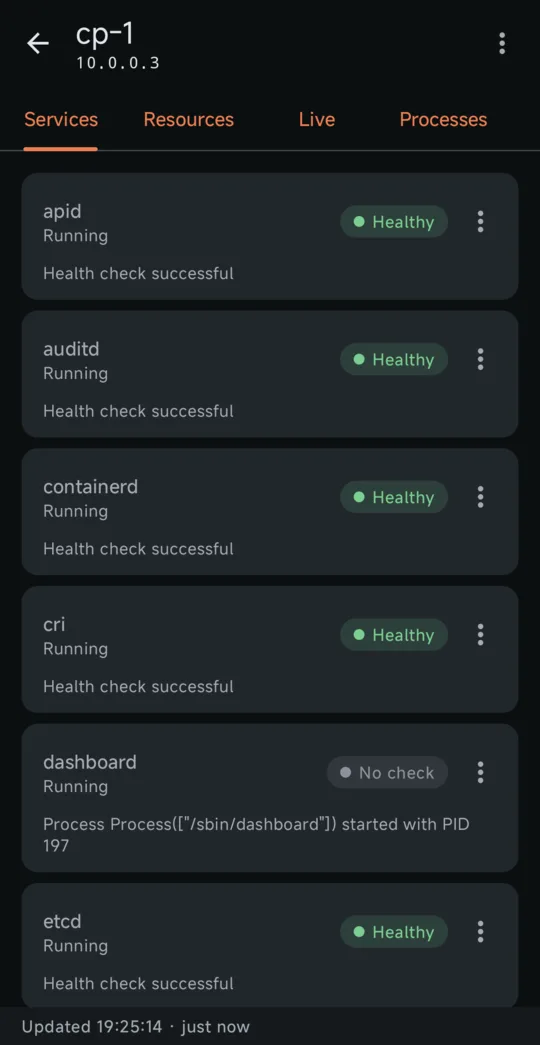
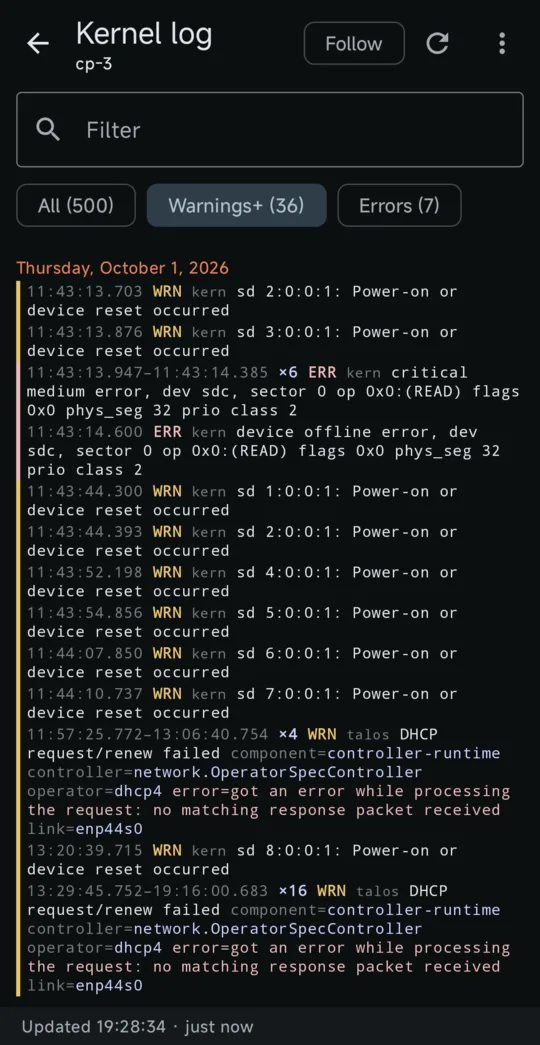
Dienste und LogsDienstzustand sowie Dienst- und Kernel-Logs, nach Level eingefärbt, mit zusammengefassten Wiederholungen und Live-Verfolgung. |
reader |
| talosctl events |
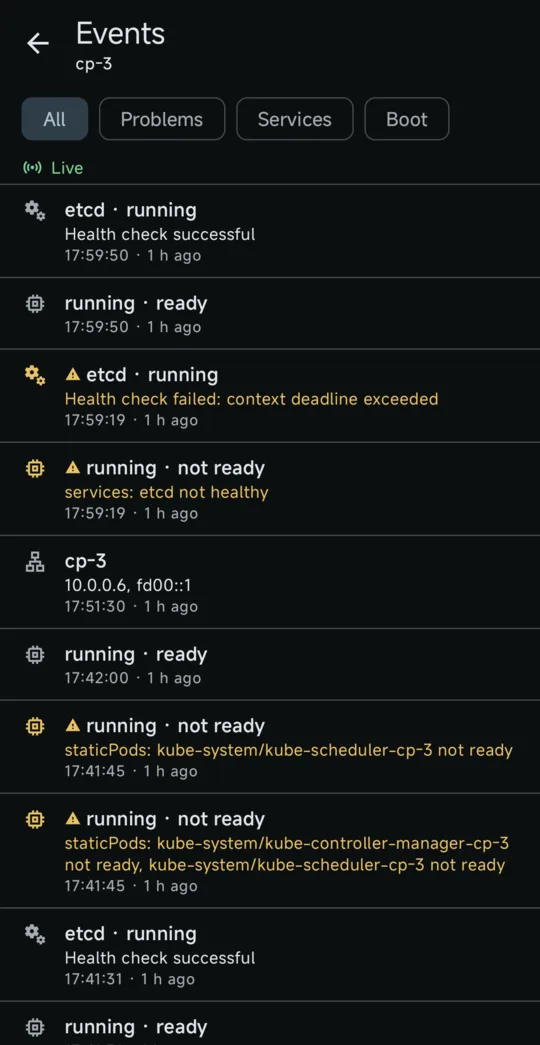
Ereignis-ZeitachseDienständerungen, Boot-Phasen und Adressänderungen im ganzen Cluster, in Echtzeit. |
reader |
| talosctl dashboard, talosctl processes |
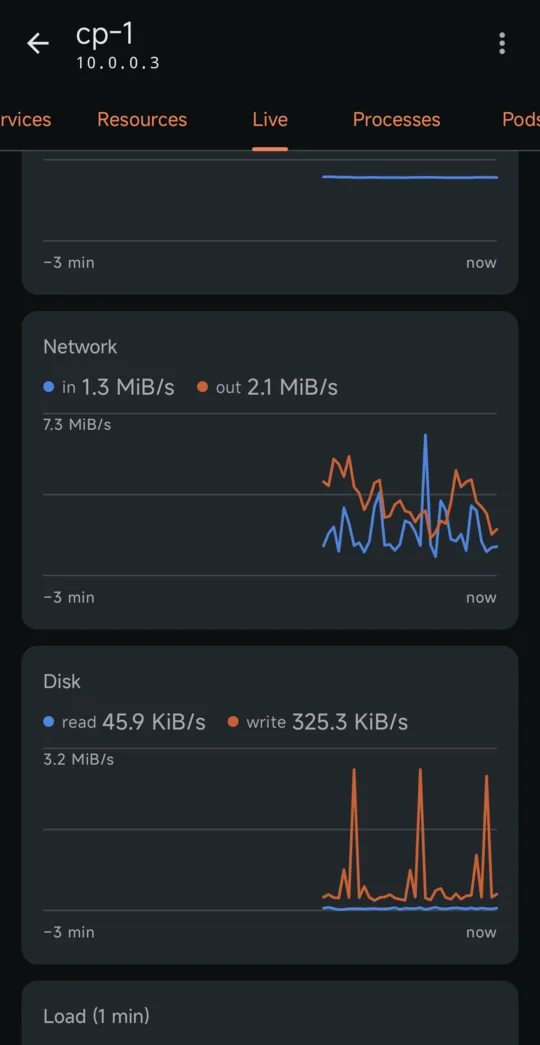
Live-Diagramme und ProzesseCPU, Speicher, Netzwerk, Datenträger und Last alle zwei Sekunden, und die Prozessliste nach CPU oder Speicher sortiert. |
reader |
| talosctl get members |
Node-ErkennungCluster-Mitglieder, die deine talosconfig noch nicht anspricht, mit einem Tipp zum Kontext hinzugefügt, und unter Android eine Suche im lokalen Netzwerk, wenn kein Endpoint antwortet. |
reader |
| diff of talosctl get … on every node |
KonfigurationsabweichungenDNS, NTP, MTUs, Erweiterungen, Secure Boot, UKI und Talos-Versionen, innerhalb einer Rolle oder mit einem gespeicherten Referenzstand verglichen. |
reader |
| talosctl events + watch, in a terminal |
VorfallsaufzeichnungEreignisse und erfasster Node-, Dienst- und Netzwerkzustand, zusammengeführt in einer gespeicherten Zeitachse. |
reader |
| talosctl read /proc/stat, /proc/diskstats |
EngpassmetrikenE/A-Wartezeit, Steal-Zeit, E/A pro Datenträger sowie Fehler und verworfene Pakete pro Schnittstelle, live. |
reader |
| talosctl containers -k |
PodsContainer nach Pod gruppiert, mit CPU und Speicher. |
reader |
| talosctl containers -k on every node |
App-InventarDie im Cluster laufende Software, gruppiert in Apps mit Logos, Versionen, Versionsabweichungen und nicht fixierten Images. |
reader |
| talosctl get links, talosctl netstat |
NetzwerkSchnittstellen, Adressen, Routen, DNS- und Zeitserver sowie offene Verbindungen. |
reader |
| talosctl apply-config --mode try |
MaschinenkonfigurationDie Konfiguration des Nodes Feld für Feld oder als YAML, Secrets verborgen, bis du sie aufdeckst. Bearbeite sie und probiere die Änderung aus: Der Node setzt sich selbst zurück, wenn du sie nicht behältst. |
admin |
| talosctl etcd status, etcd snapshot |
etcdMitglieder, Leader, Größe und Alarme, Defragmentierung und ein Snapshot, auf dem Smartphone gespeichert. |
reader / backup |
| talosctl get kubespanpeerstatuses |
KubeSpanDie Peers jedes Nodes: Status, Endpoint, letzter Handshake und Traffic, und unter Android eine Karte der Standorte, Nodes und Tunnel. |
reader |
| talosctl service restart |
DienststeuerungEinen Dienst starten, stoppen oder neu starten, mit einer Warnung bei kritischen Diensten. |
operator |
| talosctl reboot -m powercycle |
Neustart, Herunterfahren und AufweckenGeordnet, per Power-Cycle oder erzwungen, nachdem du zur Bestätigung den Hostnamen eingetippt hast. Wecke einen ausgeschalteten Node per Wake-on-LAN auf. |
operator |
| talosctl pcap |
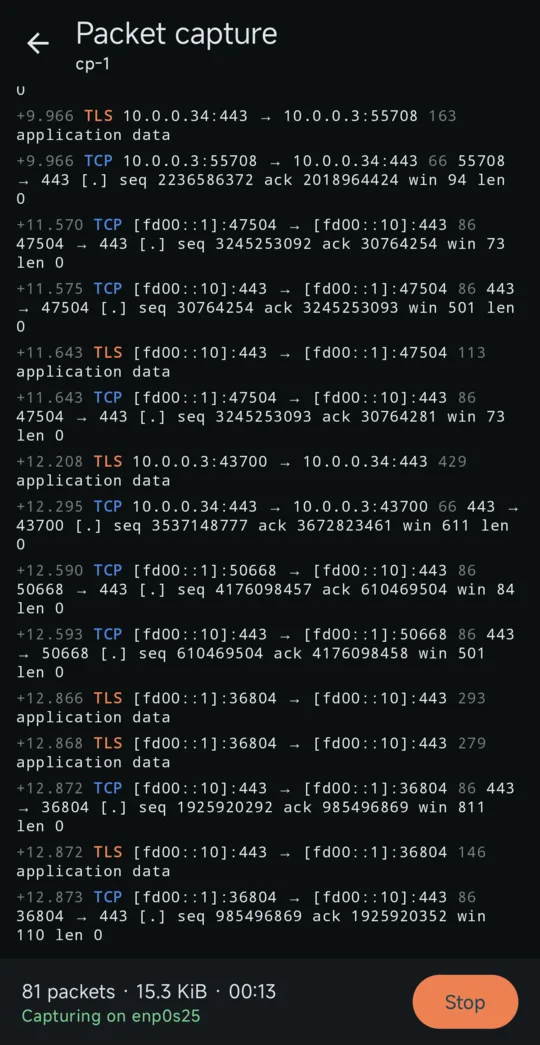
PaketmitschnittEine Live-Paketliste mit dekodierten Details, gespeichert als .pcap zum Öffnen in Wireshark. |
operator |
| talosctl upgrade |
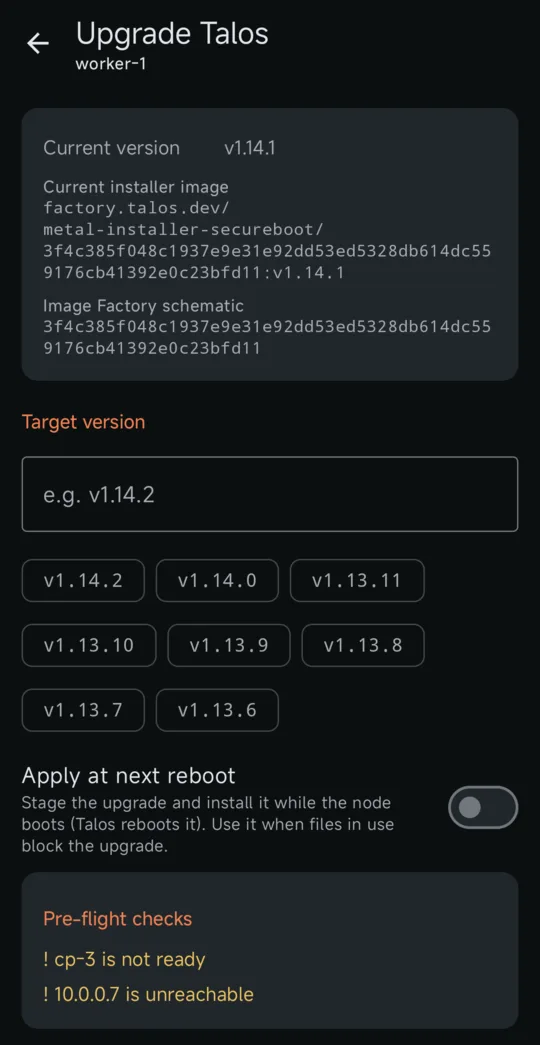
Talos-UpgradeEin Node nach dem anderen, abgelehnt, wenn etcd das Quorum verlieren würde, mit Fortschrittsanzeige, bis der Node wieder da ist. |
admin |
| kubectl get deploy,sts,ds, kubectl rollout restart |
Kubernetes-WorkloadsBereitschaft und Rollout-Status jedes Deployments, StatefulSets und DaemonSets, und ein Rolling Restart nach einer Bestätigung. |
admin |
| kubectl get cronjobs, kubectl create job --from |
Kubernetes-CronJobsZeitplan, nächster Lauf und letzte Läufe jedes CronJobs, mit dem Icon und Namen, die du ihm gibst, und ein manueller Lauf nach einer Bestätigung. |
admin |
| kubectl get pods, kubectl delete pod |
Kubernetes-PodsPod-Status, Bereitschaft, Neustarts und Node, problematische zuerst; lösche einen hängenden Pod, damit sein Controller ihn neu erstellt. |
admin |
| cilium connectivity perf, netperf |
NetzwerktestTCP-Durchsatz und Latenz von p50 bis p99 zwischen zwei Nodes, von Pod zu Pod oder Host zu Host, gespeichert und im Zeitverlauf dargestellt. |
admin |
| kubectl get volumes.longhorn.io, clusters.postgresql.cnpg.io |
DatendiensteLonghorn-Volumes, CloudNativePG-Cluster und ihre Backups, Garage, Rook Ceph, MariaDB, Percona und Dragonfly, mit dem Node hinter jedem Problem und der Lösung in der Zeile. |
admin |
| talosctl cgroups |
Node-Druck und CgroupsCPU-, Speicher- und Datenträgerdruck, der Workload, der am meisten wartet, OOM-Kills und die Nutzung pro Dienst, Pod und Container. |
admin |
| talosctl config new |
talosconfig ausstellenDas Zertifikat dieses Smartphones erneuern oder ein nur lesendes für ein anderes Gerät als QR-Code erstellen. |
admin |
| talosctl rotate-ca |
Talos-CA erneuernJeder Knoten vertraut der neuen CA, bevor die alte verschwindet, und die talosconfig dieses Handys zieht unterwegs mit. |
admin |
| talosctl health |
Cluster-ZustandsprüfungDie serverseitigen Prüfungen, live übertragen, während sie laufen. |
admin |
| talosctl debug |
Debug-ShellStarte ein Image wie nicolaka/netshoot auf einem Node und erhalte ein Terminal, mit rund 40 fertigen Befehlen. |
admin |
| dig, ping, nc -z, traceroute, curl -v |
Node-NetzwerkwerkzeugeDNS-, Ping-, Port-, Traceroute- und HTTP/TLS-Prüfungen, von einem Node aus ausgeführt und in Felder zerlegt. |
admin |
| talosctl upgrade on every node, talosctl upgrade-k8s |
Cluster-UpgradeJeder Node einer nach dem anderen, bei Bedarf vorher gedraint, und Kubernetes nach einem Dry Run, mit einer Warnung, wenn eine Erweiterung keinen Build für das Ziel hat. |
admin |
| talosctl apply-config --insecure, talosctl reset |
Node hinzufügen, ersetzen, zurücksetzenInspiziere einen Node im Wartungsmodus, sende ihm eine aus einem Mitglied erstellte Konfiguration und folge ihm, bis er beitritt; ersetze einen Control-Plane-Node mit einem geführten Plan; setze einen zurück oder lösche ihn, abgelehnt, wenn etcd kaputtginge. |
admin |
| talosctl etcd defrag, alarm disarm, bootstrap --recover-from |
etcd-ReparaturBehebe einen NOSPACE-Alarm mit einem Tipp (Snapshot, Defragmentieren, Entschärfen, Prüfen) und stelle etcd aus einem Snapshot wieder her. |
admin |
| talosctl get disks, volumestatus |
Storage und HardwareDie Partitionen, der freie Platz und die Verschlüsselung jedes Datenträgers, Sensoren, CPU-Frequenz und Drosselung sowie Ersatzteile für den Server. |
reader |
| kubectl get all -A, kubectl describe, kubectl scale |
Jedes Kubernetes-ObjektEin Browser für jede Art, jedes Objekt mit einer Zusammenfassung von Bedingungen, Besitzern und Ereignissen, YAML mit Schema-Hilfe, Skalieren, Löschen und den Aktionen, die dein RBAC erlaubt. |
RBAC |
| kubectl get svc,jobs,pvc,hpa, kubectl top |
Services, Jobs, Storage, Autoscaling, KapazitätAdressen und Routen, Load-Balancer-Pools, Job-Status und Besitzer, Claims und ihr Füllstand, HPA, KEDA, VPA und Karpenter, freier Platz pro Cluster und was der Verlust eines Nodes kosten würde. |
RBAC |
| kubectl get events -w, amtool alert, amtool silence |
Live-Ereignisse und AlertmanagerClusterweite Ereignisse in Echtzeit, aktive Alarme und Stummschaltungen, eine Stummschaltung vom Telefon aus gesetzt und Alarme auf deinem Telefon, wenn einer auslöst. |
RBAC |
| kubectl get cpol,policyreports, constraints |
RichtlinienKyverno- und Gatekeeper-Richtlinien, ihre Befunde und der Zustand der Engine; schalte eine Richtlinie zwischen Audit und Enforce um. |
RBAC |
| virtctl, kubectl get vm,vmi |
Virtuelle MaschinenKubeVirt-VMs mit Starten, Stoppen, Neustarten, Migrieren, Pausieren und einer seriellen Konsole im Terminal der App. |
RBAC |
| helm rollback, velero restore, kubectl apply --dry-run |
Helm, Velero und YAMLRolle ein Helm-Release mit seinen Hooks zurück, stelle ein Velero-Backup mit Vorschau und Namespace-Zuordnung wieder her, führe einen Zeitplan sofort aus und wende eingefügtes YAML nach einem Dry-Run-Diff an. |
RBAC |
| kubectl argo rollouts, kubectl get managed, tailscale |
Argo Rollouts, Crossplane, Tailscale, Cluster APIBefördere, brich ab oder wiederhole ein Rollout; pausiere, setze fort oder reconcile eine Crossplane-Ressource; Connectors und Proxy-Gruppen; Cluster, Maschinen und Sidero-Metal-Server. |
RBAC |
| grype, trivy image |
Image-ScanSchwachstellen der Images eines Pods, eines Workloads oder der Talos-System-Images eines Nodes, Berichte aufbewahrt mit dem, was seit dem letzten Scan neu ist. |
reader |
| git checkout -b, git commit, gh pr create |
Git und Pull RequestsDurchsuche die Dateien, die eine App ausrollt, bearbeite eine oder mehrere, prüfe den Diff und seinen kustomize-Build und öffne einen Pull Request auf GitHub, GitLab, Gitea oder Forgejo. |
Git token |
| a shell script of kubectl and talosctl calls |
RunbooksEine geordnete Liste der eigenen Aktionen der App, importiert mit vorher angezeigtem Plan, ausgeführt mit einer Bestätigung je destruktivem Schritt. |
per step |
| kubectl get <your CRD> |
PluginsZwölf eingebaute Operatoren und deine eigenen CRDs, beschrieben in einer einzigen YAML-Datei, mit Karten, Aktionen und Befunden, die den Checkup und die Alarme erreichen. |
RBAC |